Wiedersehen mit Cookie Cats
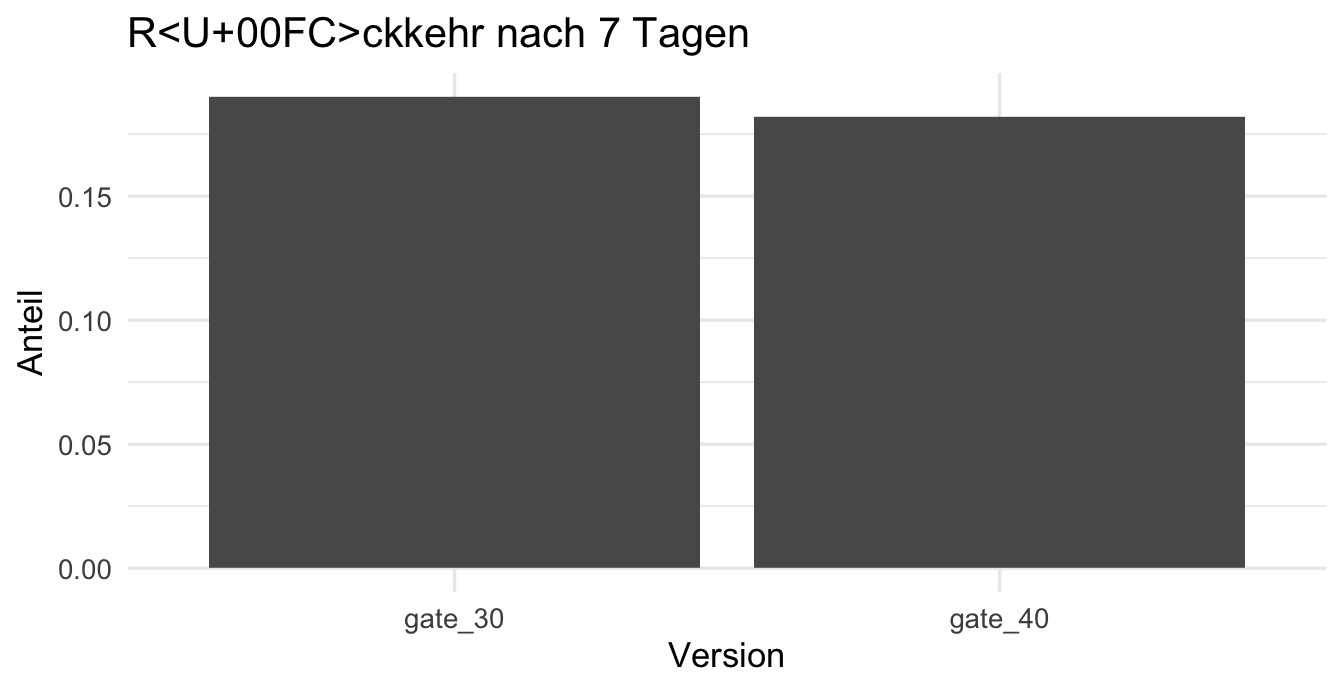
Zur Erinnerung: Im Handyspiel Cookie Cats stand das Tor, an dem Spieler warten oder bezahlen müssen, per Zufall entweder bei Level 30 oder bei Level 40. Nach 7 Tagen waren noch 19,0 % bzw. 18,2 % der Spieler dabei.
Heute klären wir: Ist dieser Unterschied echt oder Zufall? Und wo sollte das Tor stehen?
Im Basiskurs haben Sie dafür eckige Klammern und $ benutzt. Heute lernen Sie das tidyverse kennen: eine Sammlung von Paketen, mit denen sich Datenanalyse fast wie ein Satz liest.
Kurz wiederholt aus dem Basiskurs: Was liefert cats[cats$version == "gate_40", ]?
- Die Spalte
version
- Alle Spieler der Gruppe gate_40 mit allen Spalten
- Die Anzahl der Spieler in gate_40
Vor dem Komma steht die Bedingung für die Zeilen, hinter dem Komma nichts, also alle Spalten. Heute lernen Sie, dasselbe lesbarer zu schreiben.
Und was liefert mean(cats$retention_7)?
- Die Anzahl der Spieler, die zurückkamen
- Den Anteil der Spieler, die nach 7 Tagen zurückkamen
- Einen Fehler, weil die Spalte TRUE/FALSE enthält
TRUE zählt als 1, FALSE als 0. Der Mittelwert ist deshalb der Anteil. Diesen Trick brauchen Sie heute ständig.
tidyverse und die Pipe
Pakete laden und Daten einlesen
Neu: install.packages() · library() · read_csv() · glimpse()
R lässt sich mit Paketen erweitern. Ein Paket installieren Sie einmal, laden müssen Sie es in jeder neuen Sitzung:
install.packages("tidyverse")   # nur einmal
library(tidyverse)              # jedes Mal, wenn Sie RStudio neu starten
Das tidyverse bringt eine eigene Einlese-Funktion mit: read_csv() mit Unterstrich. Sie funktioniert wie read.csv(), liefert aber ein tibble. Das ist ein Data Frame, der sich übersichtlicher ausgibt:
cats <- read_csv("https://r.baartz.solutions/daten/cookie_cats.csv")
glimpse() zeigt alle Spalten mit Typ und den ersten Werten, ähnlich wie str() aus dem Basiskurs:
glimpse(cats)
#> Rows: 90,189
#> Columns: 5
#> $ userid         <dbl> 116, 337, 377, 483, 488, 540, 1066, 1444, 1574, 1587, 1~
#> $ version        <chr> "gate_30", "gate_30", "gate_40", "gate_40", "gate_40", ~
#> $ sum_gamerounds <dbl> 3, 38, 165, 1, 179, 187, 0, 2, 108, 153, 3, 0, 30, 39, ~
#> $ retention_1    <lgl> FALSE, TRUE, TRUE, FALSE, TRUE, TRUE, FALSE, FALSE, TRU~
#> $ retention_7    <lgl> FALSE, FALSE, FALSE, FALSE, TRUE, TRUE, FALSE, FALSE, T~
Im Browser sind die Pakete schon geladen und cats ist schon eingelesen. library() brauchen Sie dort nicht.
Die Pipe |>
Im Basiskurs haben Sie Funktionen ineinander geschachtelt. Das liest man von innen nach außen, was bei vielen Schritten schnell unübersichtlich wird:
round(mean(cats$sum_gamerounds), 1)
#> [1] 51.9
Die Pipe |> schreibt dieselben Schritte nacheinander. Sie nimmt das Ergebnis von links und setzt es als erstes Argument in die Funktion rechts ein. Lesen Sie sie als „und dann“:
cats$sum_gamerounds |> mean() |> round(1)
#> [1] 51.9
Nimm die Runden, und dann bilde den Mittelwert, und dann runde auf eine Stelle. Bei round(1) fehlt scheinbar das erste Argument. Das liefert die Pipe. Die 1 ist das zweite Argument, die Zahl der Nachkommastellen.
Lange Pipes verteilt man auf mehrere Zeilen. Die Pipe steht dann am Ende jeder Zeile:
cats$sum_gamerounds |>
  mean() |>
  round(1)
#> [1] 51.9
Tastenkürzel in RStudio: Strg + Shift + M (Mac Cmd + Shift + M). In älteren Anleitungen sehen Sie %>% statt |>. Das funktioniert genauso.
Aufgabe 1
Schreiben Sie diese geschachtelte Zeile mit der Pipe um. Das Ergebnis muss gleich bleiben.
round(sqrt(mean(cats$sum_gamerounds)), 1)
Die innerste Funktion kommt zuerst: mean(). Dann sqrt(), dann round().
Bei round() schreiben Sie nur noch die Stellenzahl: round(1).
Finde den Fehler 1
Jemand hat die Pipe auf zwei Zeilen verteilt. R gibt erst den ungerundeten Mittelwert aus und meldet dann einen Fehler.
R liest Zeile 1 und denkt: fertig. Wo muss die Pipe stehen, damit R weiß, dass noch etwas kommt?
Zeilen und Spalten
Das Paket dplyr aus dem tidyverse arbeitet mit Verben. Jedes Verb nimmt eine Tabelle und gibt eine Tabelle zurück. Darum lassen sie sich mit der Pipe aneinanderreihen.
Zeilen auswählen: filter()
Neu: filter() · Komma als „und“
filter() behält nur die Zeilen, auf die eine Bedingung zutrifft. Die Vergleichszeichen kennen Sie aus dem Basiskurs (==, >, <= …). Spaltennamen schreiben Sie ohne cats$:
cats |> filter(version == "gate_40")
#> # A tibble: 45,489 x 5
#>    userid version sum_gamerounds retention_1 retention_7
#>     <dbl> <chr>            <dbl> <lgl>       <lgl>
#>  1    377 gate_40            165 TRUE        FALSE
#>  2    483 gate_40              1 FALSE       FALSE
#>  3    488 gate_40            179 TRUE        TRUE
#>  4    540 gate_40            187 TRUE        TRUE
#>  5   1444 gate_40              2 FALSE       FALSE
#>  6   1574 gate_40            108 TRUE        TRUE
#>  7   1587 gate_40            153 TRUE        FALSE
#>  8   1842 gate_40              3 FALSE       TRUE
#>  9   2132 gate_40             30 TRUE        FALSE
#> 10   2502 gate_40              1 FALSE       FALSE
#> # i 45,479 more rows
Mehrere Bedingungen trennen Sie mit Komma, das heißt „und“. Für „oder“ nehmen Sie wie gewohnt |:
cats |> filter(version == "gate_40", retention_7 == TRUE)
#> # A tibble: 8,279 x 5
#>    userid version sum_gamerounds retention_1 retention_7
#>     <dbl> <chr>            <dbl> <lgl>       <lgl>
#>  1    488 gate_40            179 TRUE        TRUE
#>  2    540 gate_40            187 TRUE        TRUE
#>  3   1574 gate_40            108 TRUE        TRUE
#>  4   1842 gate_40              3 FALSE       TRUE
#>  5   3132 gate_40             80 TRUE        TRUE
#>  6   3204 gate_40             53 TRUE        TRUE
#>  7   3993 gate_40            202 TRUE        TRUE
#>  8   6930 gate_40            297 TRUE        TRUE
#>  9   7124 gate_40            108 TRUE        TRUE
#> 10  10200 gate_40            106 FALSE       TRUE
#> # i 8,269 more rows
Zum Vergleich in Basis-R: cats[cats$version == "gate_40" & cats$retention_7 == TRUE, ]. Wie viele Zeilen übrig sind, zählt nrow(), das Sie aus dem Basiskurs kennen:
cats |> filter(version == "gate_40", retention_7 == TRUE) |> nrow()
#> [1] 8279
Aufgabe 2
Wie viele Spieler aus gate_30 haben mehr als 100 Runden gespielt?
Zwei Bedingungen, getrennt durch Komma: version == "gate_30" und sum_gamerounds > 100.
Finde den Fehler 2
Gesucht sind alle Spieler aus gate_40. R schlägt Ihnen in der Fehlermeldung sogar die Lösung vor.
= speichert, == vergleicht. Was wollen Sie hier?
Spalten auswählen und sortieren
Neu: select() · arrange() · desc()
select() behält nur die genannten Spalten:
cats |> select(userid, sum_gamerounds)
#> # A tibble: 90,189 x 2
#>    userid sum_gamerounds
#>     <dbl>          <dbl>
#>  1    116              3
#>  2    337             38
#>  3    377            165
#>  4    483              1
#>  5    488            179
#>  6    540            187
#>  7   1066              0
#>  8   1444              2
#>  9   1574            108
#> 10   1587            153
#> # i 90,179 more rows
arrange() sortiert die Zeilen nach einer Spalte, normalerweise aufsteigend (kleinster Wert oben). Für absteigend (größter Wert oben) setzen Sie die Spalte in desc(), kurz für descending:
cats |> arrange(sum_gamerounds)          # wenigste Runden oben
#> # A tibble: 90,189 x 5
#>    userid version sum_gamerounds retention_1 retention_7
#>     <dbl> <chr>            <dbl> <lgl>       <lgl>
#>  1   1066 gate_30              0 FALSE       FALSE
#>  2   2101 gate_30              0 FALSE       FALSE
#>  3   3095 gate_30              0 FALSE       FALSE
#>  4   4076 gate_40              0 FALSE       FALSE
#>  5   4176 gate_30              0 FALSE       FALSE
#>  6   4881 gate_30              0 FALSE       FALSE
#>  7   6123 gate_30              0 FALSE       FALSE
#>  8   6492 gate_30              0 FALSE       FALSE
#>  9   7509 gate_40              0 FALSE       FALSE
#> 10   8379 gate_30              0 FALSE       FALSE
#> # i 90,179 more rows
cats |> arrange(desc(sum_gamerounds))    # meiste Runden oben
#> # A tibble: 90,189 x 5
#>     userid version sum_gamerounds retention_1 retention_7
#>      <dbl> <chr>            <dbl> <lgl>       <lgl>
#>  1 6390605 gate_30          49854 FALSE       TRUE
#>  2  871500 gate_30           2961 TRUE        TRUE
#>  3 3271615 gate_40           2640 TRUE        FALSE
#>  4 4832608 gate_30           2438 TRUE        TRUE
#>  5 5346171 gate_40           2294 TRUE        TRUE
#>  6 5133952 gate_30           2251 TRUE        TRUE
#>  7 9640085 gate_30           2156 TRUE        TRUE
#>  8 4090246 gate_40           2124 TRUE        TRUE
#>  9 9791599 gate_40           2063 TRUE        TRUE
#> 10  725080 gate_40           2015 TRUE        TRUE
#> # i 90,179 more rows
Aufgabe 3 · Der Ausreißer
Zeigen Sie nur die Spalten userid, version und sum_gamerounds und sortieren Sie so, dass der Spieler mit den meisten Runden oben steht.
Drei Spaltennamen mit Komma in select(). Absteigend sortieren: desc(sum_gamerounds).
Zählen: count()
count() zählt, wie oft jeder Wert einer Spalte vorkommt, wie table() im Basiskurs. Das Ergebnis ist eine Tabelle mit der Spalte n:
cats |> count(version)
#> # A tibble: 2 x 2
#>   version     n
#>   <chr>   <int>
#> 1 gate_30 44700
#> 2 gate_40 45489
Mit zwei Spalten zählt count() jede Kombination:
cats |> count(version, retention_7)
#> # A tibble: 4 x 3
#>   version retention_7     n
#>   <chr>   <lgl>       <int>
#> 1 gate_30 FALSE       36198
#> 2 gate_30 TRUE         8502
#> 3 gate_40 FALSE       37210
#> 4 gate_40 TRUE         8279
Aufgabe 4
Zählen Sie, wie viele Spieler am Tag 1 zurückkamen und wie viele nicht, getrennt nach version.
Wie im Beispiel, nur mit retention_1 statt retention_7.
Neue Spalten
Spalten berechnen: mutate()
mutate() hängt eine neue Spalte an. Links vom = steht der neue Name, rechts die Rechnung. Das entspricht cats$neu <- … aus dem Basiskurs:
cats |>
  mutate(runden_pro_tag = round(sum_gamerounds / 14, 1)) |>
  select(userid, sum_gamerounds, runden_pro_tag)
#> # A tibble: 90,189 x 3
#>    userid sum_gamerounds runden_pro_tag
#>     <dbl>          <dbl>          <dbl>
#>  1    116              3            0.2
#>  2    337             38            2.7
#>  3    377            165           11.8
#>  4    483              1            0.1
#>  5    488            179           12.8
#>  6    540            187           13.4
#>  7   1066              0            0
#>  8   1444              2            0.1
#>  9   1574            108            7.7
#> 10   1587            153           10.9
#> # i 90,179 more rows
Die neue Spalte kann auch TRUE/FALSE enthalten, wenn rechts ein Vergleich steht. So eine Spalte lässt sich danach direkt zählen:
cats |>
  mutate(tor_30_erreicht = sum_gamerounds >= 30) |>
  count(tor_30_erreicht)
#> # A tibble: 2 x 2
#>   tor_30_erreicht     n
#>   <lgl>           <int>
#> 1 FALSE           56920
#> 2 TRUE            33269
Aufgabe 5
Legen Sie mit mutate() die Spalte tor_40_erreicht an: TRUE, wenn ein Spieler mindestens 40 Runden gespielt hat. Zählen Sie dann mit count(), wie viele das Tor bei 40 erreicht haben.
Wie im zweiten Beispiel, nur mit 40: sum_gamerounds >= 40.
In Gruppen einteilen: case_when()
Neu: case_when() · Tilde ~
Mit case_when() sortieren Sie Werte in Schubladen. Jede Zeile lautet: Bedingung ~ Ergebnis. Das Zeichen ~ heißt Tilde (Windows: AltGr + +, Mac: Option + N). R prüft die Zeilen von oben nach unten, die erste passende gewinnt. TRUE ~ in der letzten Zeile fängt alles auf, was bis dahin nicht gepasst hat:
cats |>
  mutate(spielertyp = case_when(
    sum_gamerounds < 10 ~ "kurz reingeschaut",
    sum_gamerounds < 50 ~ "Gelegenheitsspieler",
    TRUE                ~ "Fan"
  )) |>
  count(spielertyp)
#> # A tibble: 3 x 2
#>   spielertyp              n
#>   <chr>               <int>
#> 1 Fan                 23165
#> 2 Gelegenheitsspieler 32787
#> 3 kurz reingeschaut   34237
Ein Spieler hat genau 10 Runden gespielt. In welcher Schublade landet er?
Gelegenheitsspieler. Die erste Bedingung sum_gamerounds < 10 ist bei genau 10 falsch, die zweite < 50 ist wahr. Bei case_when() kommt es auf die Reihenfolge und auf < oder <= an.
Aufgabe 6 · Spielertypen
Teilen Sie die Spieler mit case_when() in drei Gruppen ein und zählen Sie sie:
- unter 30 Runden:
"vor dem Tor"
- 30 bis 39 Runden:
"zwischen den Toren"
- alles andere:
"weit gekommen"
Die erste passende Zeile gewinnt. Wer nicht unter 30 ist, landet in Zeile 2. Dort reicht deshalb sum_gamerounds < 40.
Finde den Fehler 3
Dieser case_when()-Befehl soll Spieler in Vielspieler und Wenigspieler einteilen.
Was steht in case_when() zwischen Bedingung und Ergebnis?
Zusammenfassen und Gruppieren
Zusammenfassen: summarise()
Neu: summarise() · median() · n()
summarise() fasst eine ganze Tabelle zu einer Zeile zusammen. Wie bei mutate() geben Sie jeder Kennzahl einen Namen:
cats |>
  summarise(
    spieler   = n(),                     # n() zählt die Zeilen
    runden_mw = mean(sum_gamerounds),    # Mittelwert
    runden_md = median(sum_gamerounds)   # Median
  )
#> # A tibble: 1 x 3
#>   spieler runden_mw runden_md
#>     <int>     <dbl>     <dbl>
#> 1   90189      51.9        16
Neu ist der Median: Er ist der mittlere Wert, wenn man alle Werte der Größe nach sortiert. Die Hälfte der Spieler hat also höchstens 16 Runden gespielt. Anders als der Mittelwert lässt sich der Median von einzelnen Ausreißern kaum beeinflussen.
Aufgabe 7
Berechnen Sie mit summarise() in einer Zeile: die Quote der Rückkehrer nach 1 Tag (tag_1) und nach 7 Tagen (tag_7), jeweils über alle Spieler.
Die Quote ist der Mittelwert der TRUE/FALSE-Spalte: mean(retention_1).
Pro Gruppe: group_by()
Steht group_by() vor summarise(), bekommen Sie eine Zeile pro Gruppe. Das ist das wichtigste Werkzeug des Tages, denn genau so vergleicht man die beiden Versionen:
cats |>
  group_by(version) |>
  summarise(
    spieler   = n(),
    runden_mw = mean(sum_gamerounds),
    runden_md = median(sum_gamerounds)
  )
#> # A tibble: 2 x 4
#>   version spieler runden_mw runden_md
#>   <chr>     <int>     <dbl>     <dbl>
#> 1 gate_30   44700      52.5        17
#> 2 gate_40   45489      51.3        16
Der Mittelwert ist bei gate_30 etwas höher, der Median kaum. Das liegt am Ausreißer aus Aufgabe 3. Ohne ihn spielen beide Gruppen im Schnitt exakt gleich viel:
cats |>
  filter(sum_gamerounds < 10000) |>
  group_by(version) |>
  summarise(runden_mw = mean(sum_gamerounds))
#> # A tibble: 2 x 2
#>   version runden_mw
#>   <chr>       <dbl>
#> 1 gate_30      51.3
#> 2 gate_40      51.3
Aufgabe 8 · Die Tabelle für den Chef
Berechnen Sie pro version die Rückkehrquoten nach 1 und nach 7 Tagen, in Prozent und auf eine Stelle gerundet.
tag_7 wird genauso berechnet wie tag_1, nur mit retention_7.
Aufgabe 9 · Nur wer bis zum Tor kommt
Für Spieler, die nie Level 40 erreichen, ist die Version eigentlich egal. Berechnen Sie die 7-Tage-Quote in Prozent pro version nur für Spieler mit mindestens 40 Runden.
Erst filtern (sum_gamerounds >= 40), dann gruppieren, dann round(mean(retention_7) * 100, 1).
Finde den Fehler 4
Gesucht ist der Median der Runden pro Version. Der Code läuft ohne Fehlermeldung, das Ergebnis ist trotzdem falsch. Warum?
Wie viele Zeilen hat das Ergebnis? Und wie viele sollten es sein?
Grafiken mit ggplot2
Das Grundgerüst
Neu: ggplot() · aes() · geom_col() · labs() · +
Jede ggplot-Grafik wird aus Schichten gebaut, die mit + verbunden werden:
ggplot(daten, aes(x = …, y = …)): welche Tabelle, welche Spalte auf welche Achse. aes() steht für aesthetics, die Zuordnung von Spalten zu Achsen und Farben.geom_…(): welche Form. geom_col() zeichnet Balken mit der Höhe aus y.labs(): Beschriftungen wie Titel und Achsennamen.
quoten <- cats |>
  group_by(version) |>
  summarise(tag_7 = mean(retention_7))

ggplot(quoten, aes(x = version, y = tag_7)) +
  geom_col() +
  labs(title = "Rückkehr nach 7 Tagen", x = "Version", y = "Anteil")
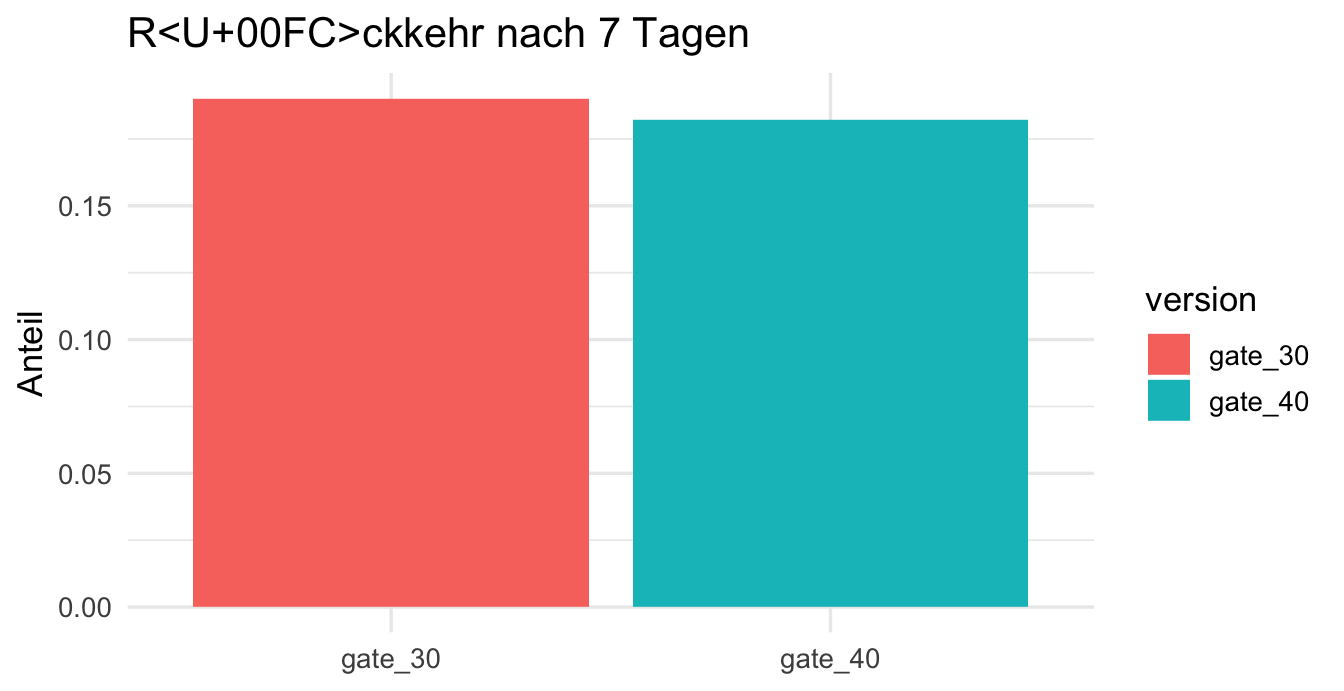
Mit fill = version in aes() bekommt jede Version eine eigene Farbe:
ggplot(quoten, aes(x = version, y = tag_7, fill = version)) +
  geom_col() +
  labs(title = "Rückkehr nach 7 Tagen", x = NULL, y = "Anteil")
Aufgabe 10
Zeichnen Sie ein Balkendiagramm der 1-Tages-Quote pro Version mit einem Titel. Die Tabelle quoten_1 mit den Spalten version und tag_1 ist schon vorbereitet.
Auf die x-Achse kommt version, auf die y-Achse tag_1. Der Titel ist Text, also in Anführungszeichen.
Verteilungen zeigen
Neu: geom_histogram() · geom_boxplot() · Pipe bis ggplot()
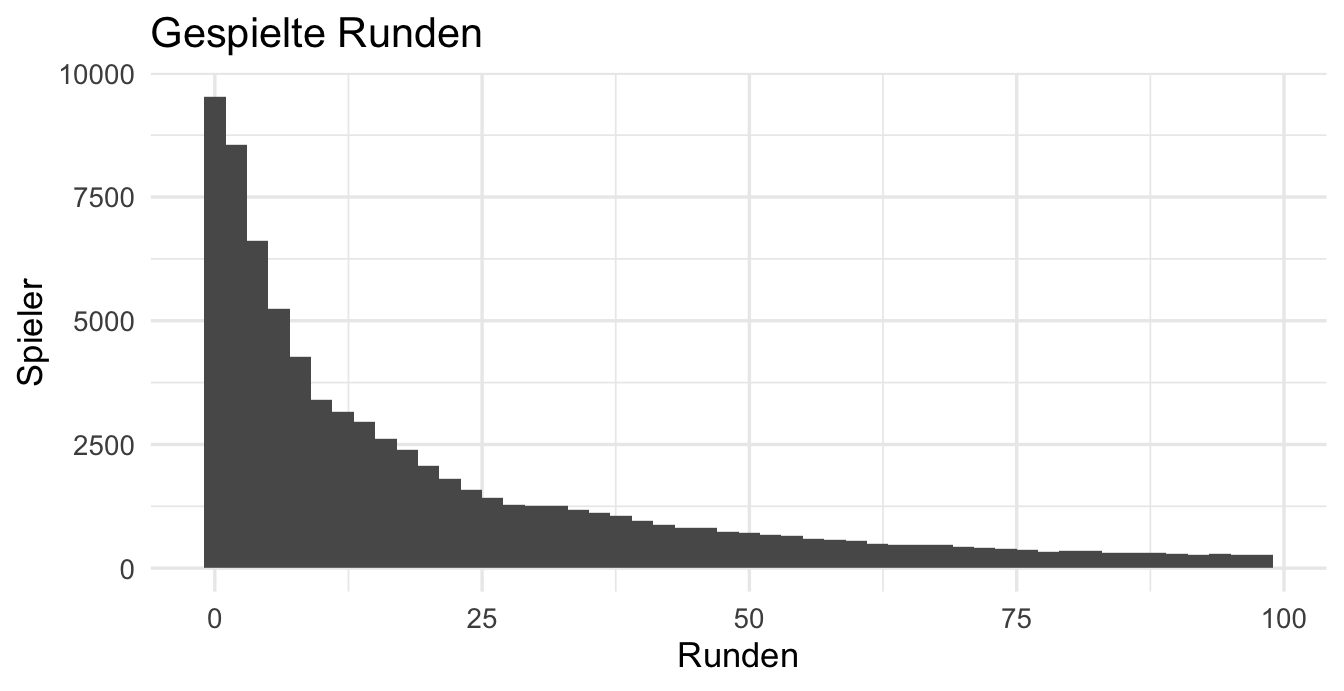
Ein Histogramm zeigt, wie sich die Werte einer Spalte verteilen. Es braucht nur x. binwidth legt fest, wie breit jeder Balken ist. Die Tabelle können Sie vorher mit der Pipe filtern und dann an ggplot() weitergeben. Ab ggplot() geht es mit + weiter, nicht mit |>:
cats |>
  filter(sum_gamerounds < 100) |>
  ggplot(aes(x = sum_gamerounds)) +
  geom_histogram(binwidth = 2) +
  labs(title = "Gespielte Runden", x = "Runden", y = "Spieler")
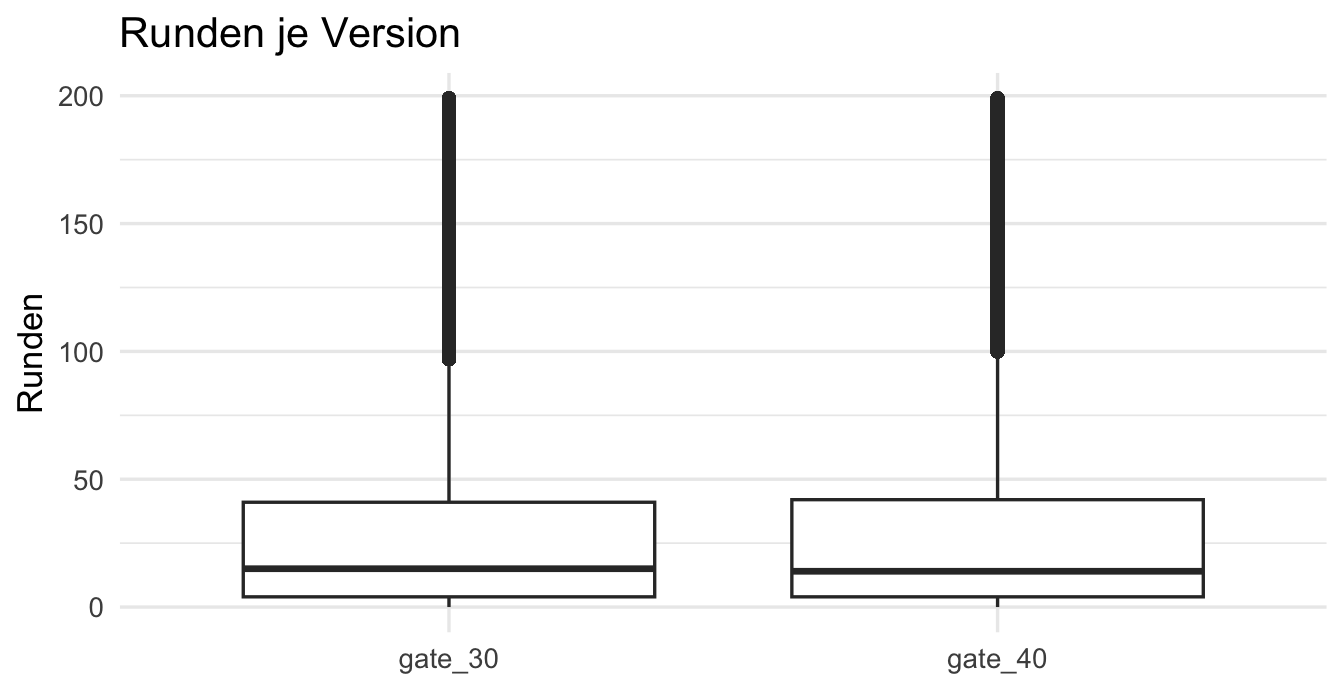
Ein Boxplot fasst eine Verteilung pro Gruppe zusammen: Der Strich in der Box ist der Median, die Box umfasst die mittlere Hälfte der Werte.
cats |>
  filter(sum_gamerounds < 200) |>
  ggplot(aes(x = version, y = sum_gamerounds)) +
  geom_boxplot() +
  labs(title = "Runden je Version", x = NULL, y = "Runden")
Aufgabe 11 · Bonus
Zeichnen Sie ein Histogramm der Runden für alle Spieler mit weniger als 50 Runden, mit Balkenbreite 1.
Filter: sum_gamerounds < 50. Auf die x-Achse kommt sum_gamerounds.
Finde den Fehler 5
Diese Grafik soll einen Boxplot der Runden zeigen. R beschwert sich.
Womit werden ggplot-Schichten verbunden?
Zufall oder echt?
Die Idee des Tests
Neu: p-Wert · prop.test()
Stellen Sie sich vor, das Tor hätte gar keinen Einfluss. Dann würden die zwei Gruppen trotzdem nie exakt gleich abschneiden, ein bisschen Zufall ist immer dabei. Die Frage ist: Wie wahrscheinlich ist ein Unterschied von 0,8 Prozentpunkten, wenn in Wahrheit keiner da ist? Diese Wahrscheinlichkeit ist der p-Wert. Üblich ist die Grenze 0,05: Liegt p darunter, spricht man von einem signifikanten Unterschied.
Für Anteile in zwei Gruppen gibt es prop.test(). Er braucht zwei Vektoren: wie viele Spieler zurückkamen (x) und wie viele es insgesamt waren (n). Beides liefert summarise(). sum() einer TRUE/FALSE-Spalte zählt die TRUE-Werte, das kennen Sie aus dem Basiskurs:
cats |>
  group_by(version) |>
  summarise(zurueck = sum(retention_7), spieler = n())
#> # A tibble: 2 x 3
#>   version zurueck spieler
#>   <chr>     <int>   <int>
#> 1 gate_30    8502   44700
#> 2 gate_40    8279   45489
Die Zahlen tippen Sie in prop.test(), in derselben Reihenfolge:
prop.test(x = c(8502, 8279), n = c(44700, 45489))
#>
#>  2-sample test for equality of proportions with continuity correction
#>
#> data:  c(8502, 8279) out of c(44700, 45489)
#> X-squared = 9.9591, df = 1, p-value = 0.001601
#> alternative hypothesis: two.sided
#> 95 percent confidence interval:
#>  0.003098867 0.013303730
#> sample estimates:
#>    prop 1    prop 2
#> 0.1902013 0.1820000
Wichtig ist die Zeile mit p-value: p = 0,0016. Wenn das Tor keinen Einfluss hätte, sähen wir einen so großen Unterschied nur in etwa 16 von 10.000 Experimenten. Der Unterschied ist also signifikant.
Was bedeutet p = 0,0016 hier?
- Das Tor bei Level 40 senkt die Rückkehr um 0,16 %
- Ein so großer Unterschied wäre sehr unwahrscheinlich, wenn das Tor keinen Einfluss hätte
- Mit 99,84 % Wahrscheinlichkeit ist gate_30 besser
Der p-Wert sagt nichts über die Größe des Effekts und ist auch nicht die Wahrscheinlichkeit, dass eine Hypothese stimmt. Er sagt nur: So ein Ergebnis wäre unter „kein Unterschied“ sehr überraschend.
Aufgabe 12 · Und nach einem Tag?
Testen Sie genauso, ob sich die 1-Tages-Quote der beiden Versionen unterscheidet. Berechnen Sie zuerst die Zahlen mit summarise() und tippen Sie sie dann in prop.test().
Erster Teil: sum(retention_1). Klicken Sie Ausführen, lesen Sie die zwei Zahlen in der Spalte zurueck ab und tragen Sie sie in x = c(…, …) ein.
Für Mittelwerte gibt es t.test(), für schiefe Verteilungen wie die Runden wilcox.test(), für Zusammenhänge cor.test(). Alle liefern einen p-Wert, den Sie genauso lesen.
Die Antwort
Das Tor sollte bei Level 30 bleiben. Nach 7 Tagen kommen mit dem Tor bei Level 30 mehr Spieler zurück (19,0 % gegen 18,2 %), und dieser Unterschied ist sehr wahrscheinlich kein Zufall (p = 0,0016). Am deutlichsten ist er bei den Spielern, die das Tor überhaupt erreichen.
Sie haben heute eine komplette Datenanalyse gemacht: Daten einlesen, auswählen, zusammenfassen, zeichnen und testen. Mit Quarto (in RStudio: File → New File → Quarto Document) schreiben Sie daraus einen Bericht, in dem Text, Code und Grafiken zusammen in einem Dokument stehen. Diese Kursseite ist übrigens genau so entstanden.
Spickzettel
library(tidyverse)
tidyverse laden
read_csv("datei.csv")
Daten einlesen
filter(a == 1, b > 2)
Zeilen auswählen
select(a, b)
Spalten auswählen
arrange(desc(a))
absteigend sortieren
count(a, b)
Kombinationen zählen
mutate(neu = …)
neue Spalte
case_when(bed ~ "wert")
in Gruppen einteilen
group_by(a) |> summarise(m = mean(b))
Kennzahl pro Gruppe
ggplot(d, aes(x, y)) + geom_col()
Grafik in Schichten
prop.test(x, n)
Anteile testen